a cura di Michela Perrone - giornalista
Nel 1981 la rivista Fortune dedicò la copertina alla Merck, prima azienda farmaceutica a introdurre sistematicamente il computer nella scoperta di nuovi farmaci. Quarant’anni dopo, nel 2020, la stessa rivista tornò sul tema. Questa volta, al centro c’era l’intelligenza artificiale. «Per chi lavora nel drug design computazionale il passaggio può sembrare naturale: sempre computer, sempre algoritmi. Ma in realtà sono due ambiti profondamente diversi – spiega Maria Cristina De Rosa, ricercatrice del Consiglio Nazionale delle Ricerche (CNR) – La differenza è nel modo in cui si costruisce la previsione. La chimica computazionale classica si basa sulle leggi della fisica e della matematica. L’intelligenza artificiale, invece, apprende dai dati storici».
Il drug design computazionale utilizza simulazioni e modelli matematici per progettare molecole prima della sperimentazione in laboratorio. L’intelligenza artificiale sta cambiando il modo in cui vengono scoperti e progettati i farmaci: oggi gli algoritmi entrano stabilmente nelle prime fasi della drug discovery, aiutando i ricercatori a selezionare molecole, prevederne le proprietà e ridurre tempi e costi di sviluppo. «Non siamo più nella fase della sola sperimentazione» – osserva Antonio Lavecchia, direttore del Drug Discovery Lab dell’Università di Napoli – Molte aziende farmaceutiche hanno ormai integrato stabilmente l’AI nelle prime fasi della scoperta dei farmaci». Gli Stati Uniti guidano il settore, seguiti da Regno Unito e Cina. In Italia, invece, «la qualità scientifica è alta, ma manca ancora una forte integrazione tra ricerca, investimenti e industria», commenta l’esperto.
La contaminazione disciplinare
Il primo effetto concreto dell’intelligenza artificiale nei laboratori non riguarda soltanto le tecnologie, ma le persone. I gruppi di ricerca stanno diventando sempre più multidisciplinari: chimici, biologi, data scientist ed esperti di machine learning lavorano insieme lungo la stessa pipeline. «Il mio gruppo è cambiato molto negli ultimi anni – racconta Lavecchia – Alle competenze tradizionali di modellistica molecolare si sono affiancati giovani ricercatori focalizzati su AI generativa ed Explainable AI (XAI). Il problema, oggi, è riuscire a trattenerli quando finiscono i finanziamenti straordinari come quelli del Piano Nazionale di Ripresa e Resilienza (PNRR)». Anche Maria Cristina De Rosa insiste sul tema della contaminazione disciplinare. «Non si tratta di trasformare un chimico in un informatico, ma di creare figure capaci di dialogare. Il punto centrale è costruire un linguaggio comune tra chi sviluppa algoritmi e chi deve interpretarli biologicamente». Il problema non è secondario: un modello matematico può avere ottime performance statistiche e risultare comunque poco utile per chi lavora in laboratorio. «Per un data scientist una buona previsione può essere una metrica numerica. Per un biologo deve essere qualcosa di verificabile sperimentalmente e realmente utile», riporta Antonio Lavecchia.
Meno tentativi alla cieca
Il motivo per cui il settore farmaceutico investe così tanto nell’intelligenza artificiale è semplice: sviluppare un farmaco richiede tempi lunghissimi, costi enormi e un tasso di fallimento elevato. In quest’ambito l’AI ha già mostrato risultati concreti: gli algoritmi funzionano molto bene nel virtual screening su larga scala (cioè la selezione computazionale di milioni di molecole candidate), nella predizione di tossicità e farmacocinetica e nella progettazione di nuove molecole. «I modelli generativi sono ormai capaci di proporre composti chimicamente plausibili e sempre più “drug-like” – spiega Lavecchia – Il passaggio dall’idea iniziale alla selezione di molecole interessanti è decisamente più rapido». Anche De Rosa sottolinea l’efficacia degli strumenti nelle fasi iniziali della scoperta. «Questi approcci sono eccellenti nell’esplorazione dei dati e nell’identificazione di molecole promettenti. Il problema emerge quando bisogna trasferire quelle previsioni in sistemi biologici complessi». Ed è proprio qui che compare il principale limite dell’intelligenza artificiale applicata al farmaco: la biologia reale.
Il limite della black box
Uno dei temi più discussi riguarda la natura opaca dei modelli di deep learning. Gli algoritmi possono produrre previsioni molto accurate senza riuscire a spiegare chiaramente il perché delle loro decisioni. «La completa spiegabilità non è oggi un prerequisito assoluto – chiarisce Lavecchia – Quello che conta è che il processo sia trasparente, tracciabile e validabile sperimentalmente». In un ambito delicato come quello farmaceutico, tuttavia, comprendere il ragionamento alla base delle previsioni resta fondamentale. E infatti De Rosa, che proviene dalla tradizione della chimica computazionale “razionale”, insiste sulla necessità di mantenere sempre un legame forte con il dato biologico: «Noi non consideriamo mai sufficiente una predizione algoritmica se non è supportata da evidenze chimiche e sperimentali. L’intelligenza artificiale deve restare un supporto alla decisione, non un sostituto del ragionamento scientifico». Il problema diventa evidente soprattutto nelle fasi cliniche. Secondo i ricercatori, gli algoritmi attualmente sono molto efficaci nel generare molecole candidate, ma la percentuale di successo cala drasticamente quando si passa agli studi più avanzati: «Generare una molecola plausibile oggi è relativamente semplice – osserva Lavecchia – Molto più difficile è dimostrare che funzionerà davvero in un organismo umano complesso». Per questo molti gruppi stanno cercando di integrare l’intelligenza artificiale con sistemi biologici più sofisticati: organoidi, organ-on-chip e modelli di digital twin. «La sfida dei prossimi anni sarà proprio colmare il gap traslazionale – dice Maria Cristina De Rosa – Non basta avere modelli eccellenti nei benchmark: bisogna arrivare fino al paziente».
La questione dei dati: quantità contro qualità
Sappiamo che tutta l’intelligenza artificiale dipende dai dati e dalla loro qualità. E nel settore farmaceutico il nodo è ancora più delicato. «Il bias nasce dal fatto che l’AI apprende dai dati disponibili – ricorda Lavecchia – Se questi sono incompleti o poco rappresentativi, anche le conclusioni rischiano di essere distorte. Per ridurre questo rischio non basta correggere il modello: bisogna costruire un sistema di contrappesi lungo tutto il processo». Il punto non riguarda soltanto la quantità delle informazioni raccolte, ma soprattutto la loro qualità e standardizzazione. «Nel drug discovery i dati sono spesso eterogenei e rumorosi – aggiunge De Rosa – Quando ci si sposta verso sistemi nuovi, dove le informazioni disponibili sono limitate, la capacità predittiva può ridursi molto». Per ridurre il rischio di bias servono quindi dataset più vari, benchmark condivisi, validazioni indipendenti e controlli continui nel tempo. «È importante avere informazioni non solo sui casi che confermano un’ipotesi, ma anche su quelli che la smentiscono – sottolinea Lavecchia – Più i dati sono equilibrati, più il modello è affidabile». E il lavoro non finisce qui: «I modelli non devono essere considerati definitivi, ma vanno costantemente monitorati e rivalutati man mano che cambiano dati, contesti e conoscenze».
| AlphaFold e la democratizzazione della biologia strutturale |
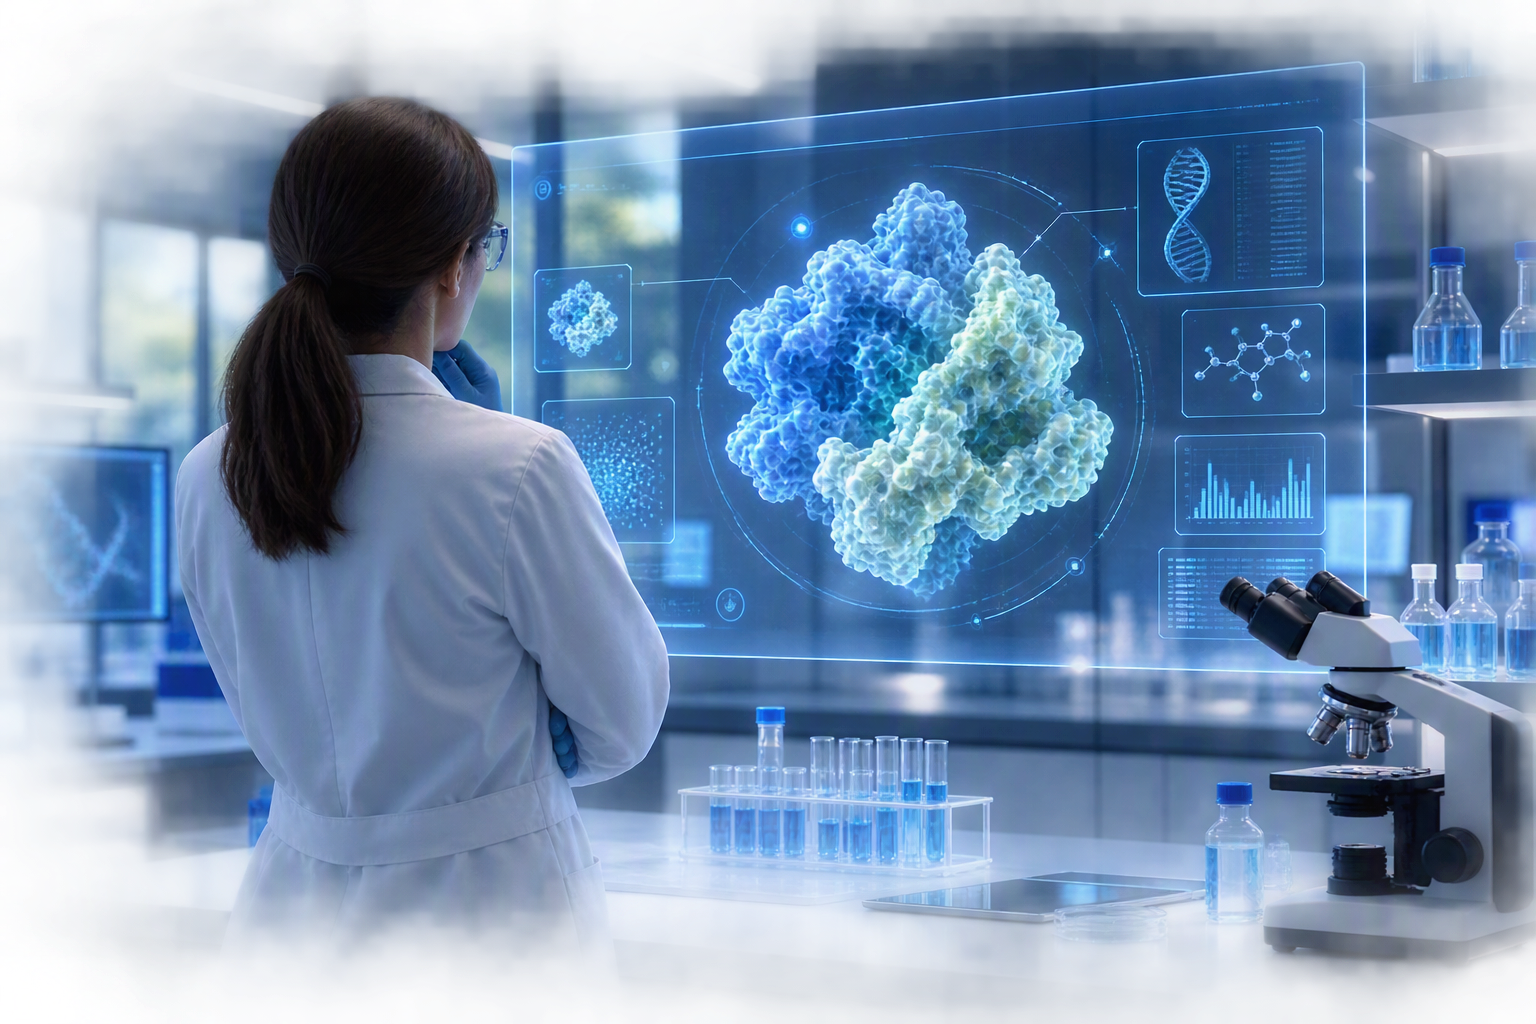
| Il caso simbolo dell’irruzione dell’AI nelle bioscienze è stato AlphaFold, il sistema sviluppato da DeepMind che ha rivoluzionato la previsione della struttura delle proteine. Per molti ricercatori è stato un cambio di paradigma. «AlphaFold ha democratizzato l’accesso alla biologia strutturale – conferma De Rosa – Oggi moltissimi laboratori possono visualizzare in 3D strutture proteiche che prima richiedevano anni di lavoro sperimentale». Lavecchia sottolinea soprattutto l’impatto pratico dello strumento. «Con AlphaFold 3 stiamo entrando nel terreno delle interazioni tra biomolecole, quindi in un contesto molto più vicino a quello reale in cui agiscono i farmaci». Entrambi, però, mettono in guardia da facili entusiasmi: «AlphaFold non elimina il bisogno della biologia strutturale sperimentale – precisa De Rosa – Fornisce una fotografia statica. Ma i recettori biologici sono dinamici, cambiano conformazione, interagiscono con l’ambiente cellulare». Il sistema, inoltre, resta dipendente, ancora una volta, dalla qualità dei dati di partenza: «Funziona benissimo perché si appoggia a database straordinari come la Protein Data Bank – aggiunge la ricercatrice del CNR – Tuttavia, dove mancano informazioni sperimentali, anche la previsione mostra i suoi limiti». |
Le regole e la collaborazione pubblico-privato
La rapidità con cui l’intelligenza artificiale evolve sta imponendo anche un ripensamento normativo. L’Europa è stata la prima area del mondo a dotarsi di un quadro regolatorio organico con l’AI Act, entrato in vigore nel 2024. «L’approccio europeo basato sul rischio è positivo – sostiene Lavecchia – Le applicazioni sanitarie richiedono standard più stringenti su qualità dei dati, supervisione umana e trasparenza». Anche De Rosa vede nell’Europa un possibile modello di equilibrio tra innovazione e tutela. «Mi convince l’idea che l’Europa mantenga un ruolo di regolatore, soprattutto in ambiti delicati come salute ed educazione», dice l’esperta. Ma proprio la velocità con cui evolve l’intelligenza artificiale rischia di mettere in difficoltà il sistema regolatorio: «Il rischio è che norme troppo complesse rallentino la ricerca – osserva ancora De Rosa – Le strutture cliniche stanno già affrontando enormi difficoltà organizzative legate a privacy, gestione dei dati e compliance». Antonio Lavecchia individua un problema simile soprattutto per startup e piccoli gruppi accademici: «Servono linee guida più semplici e percorsi di accompagnamento più chiari», afferma. Un ultimo nodo critico riguarda il gap crescente tra ricerca pubblica e privata nell’accesso alle tecnologie e alle infrastrutture. «Il rischio è che il pubblico rimanga cultore della conoscenza, ma che poi per avere certi risultati rapidamente debba necessariamente fare riferimento alle infrastrutture private – osserva De Rosa – Io ho visto delle realtà private che sono molto avanti in ambito farmaceutico, hanno investito in infrastrutture di calcolo già da alcuni anni, quindi partono avvantaggiate. Mi riferisco anche alla realtà italiana, senza considerare il livello globale». Le soluzioni? «Sicuramente fare progettazione condivisa – spiega l’esperta – ma questo credo che sia un vantaggio reciproco che tutte e due le parti riconoscono. L’altra soluzione ovviamente è l’investimento a livello nazionale».
Il vero collo di bottiglia resta la clinica
Nonostante l’entusiasmo, nessuno dei due ricercatori pensa che l’intelligenza artificiale possa sostituire il lavoro sperimentale o risolvere automaticamente il problema della scoperta dei farmaci. «Il vero banco di prova resta la clinica – osserva Lavecchia – I tempi, i costi e l’incertezza delle sperimentazioni sull’uomo continuano a essere altissimi». Per De Rosa, l’ostacolo maggiore è l’illusione di una risposta automatica: «Più le tecnologie diventano facili da usare, più aumenta il rischio di appiattimento e perdita di comprensione dei meccanismi biologici», avverte. Lo osserviamo nella nostra vita quotidiana: l’intelligenza artificiale spesso non è un supporto ma diventa un pigro sostituto del ragionamento. Perché gli scienziati non dovrebbero ricadere in questo meccanismo? La sfida dei prossimi anni, quindi, non sarà semplicemente usare più intelligenza artificiale, ma costruire modelli affidabili, integrati e realmente traducibili nella pratica clinica. «L’AI può accelerare enormemente la ricerca – conclude Lavecchia – Ma il punto decisivo non è generare più molecole. È capire quali abbiano davvero possibilità di diventare farmaci efficaci e sicuri per i pazienti».
| Il CERN dell’AI |
| Il premio Nobel Giorgio Parisi ha recentemente proposto la creazione di un “CERN dell’AI” europeo, un grande centro pubblico e condiviso dedicato alla ricerca sull’intelligenza artificiale. Secondo Antonio Lavecchia, l’idea è importante perché «l’intelligenza artificiale non è solo una tecnologia, ma un’infrastruttura strategica», oggi concentrata soprattutto nelle mani di aziende private statunitensi e cinesi. Un centro europeo potrebbe quindi rafforzare la sovranità tecnologica, favorire la collaborazione scientifica e garantire maggiore trasparenza, anche nel settore farmaceutico. Maria Cristina De Rosa si dice pienamente favorevole: «Da europeista convinta, sono assolutamente favorevole», sottolineando però che il progetto dovrebbe essere sostenuto nel lungo periodo con investimenti stabili e condivisi tra gli Stati membri. Per la ricercatrice, inoltre, l’Europa dovrebbe mantenere anche un ruolo regolatore, affinché lo sviluppo dell’intelligenza artificiale in ambito sanitario sia guidato «da scelte per il bene della comunità» e non soltanto dagli interessi delle grandi aziende tecnologiche. De Rosa insiste soprattutto sulla necessità di investimenti pubblici coordinati. «Da soli i singoli Stati europei difficilmente possono competere con Stati Uniti e Cina. Serve una governance comune e investimenti stabili nel tempo». |
Articolo tratto dall’edizione cartacea n.8, settembre 2026, p.76